AI SEO In Detail › Modul A · Grundlagen › Folge 3
DataForSEO API von Null: dein erster Call
Richte einen DataForSEO-Account ein, teste kostenlos in der Sandbox, mach deinen ersten bezahlten SERP-Live-Call, lies das JSON und cache die Antwort.
Beim Abspielen wird das Video von YouTube geladen (erweiterter Datenschutzmodus). Das Video ist auf Englisch, mit Untertiteln in deiner Sprache.
Starter-Skript für den ersten DataForSEO-Call
Ein kleines Python-Starter-Skript für DataForSEO: Zugangsdaten aus Umgebungsvariablen, kostenlose Guthabenabfrage, eine Live-Anfrage für eine Ergebnisseite mit Kostenabfrage, Statuscodes pro Task geprüft und die Rohantwort im Cache gespeichert, bevor sie in SQLite geparst wird.
- Zugangsdaten außerhalb des Projekts — Lege dein API-Login und dein API-Passwort in einer privaten Datei in deinem Home-Ordner ab und lade sie als Umgebungsvariablen. Im Skript selbst stehen sie nie.
- Erst der kostenlose Check, dann die Sandbox — Führe den kostenlosen Guthaben-Call aus, um zu prüfen, ob deine Zugangsdaten funktionieren. Baue und teste dein Parsing danach in der Sandbox, die Dummy-Daten liefert und nicht berechnet wird.
- Ein Live-Call, gecacht — Das Skript zeigt die geschätzten Kosten, fragt nach einem Ja, speichert das rohe JSON vor dem Parsen und schreibt pro Ergebnis eine Zeile in SQLite. Weitere Durchläufe lesen den Cache, kostenlos.
Python 3.9+ · nur Standardbibliothek · keine Keys enthalten · ohne Anmeldung
Die Dateien sind auf Englisch.
955 Wörter · Übersetzung des gesprochenen Textes der Episode.
Intro
Die DataForSEO-Dokumentation hat Hunderte von Endpoints. Du öffnest sie, scrollst, und eine Stunde später hast du noch keine einzige Anfrage gestellt.
Du brauchst keine Hunderte von Endpoints. Für den Anfang brauchst du drei Dinge: sicher gespeicherte Zugangsdaten, einen kostenlosen Aufruf, der prüft, ob alles funktioniert, und einen bezahlten Aufruf, der etwas Nützliches liefert.
In dieser Folge gehen wir vom neuen Konto zur Live-Ergebnisseite in Python, lesen die Antwort und speichern sie, damit wir nie doppelt zahlen.
Account und Zugangsdaten
Zuerst das Konto. Du meldest dich an, zahlst etwas ein, und die API ist Pay-as-you-go. Kein Abo. Jeder Aufruf wird von deinem Guthaben abgebucht.
Im Dashboard findest du deinen API-Login und ein API-Passwort. Achtung: Das API-Passwort ist nicht dein Login-Passwort für die Website. Die API nutzt Basic Authentication: Login und API-Passwort bei jeder Anfrage.
Jetzt die wichtigste Gewohnheit dieser Folge. Diese Zugangsdaten kommen nie in dein Skript. Nicht in den Code, nicht in ein Notebook, nicht in einen Chat mit einer KI.
Ich lege sie in eine kleine Umgebungsdatei in meinem Home-Ordner, außerhalb aller Projekte, nur für meinen Benutzer lesbar. Das Skript liest zur Laufzeit zwei Umgebungsvariablen. So kann der Projektordner geteilt, synchronisiert oder versioniert werden, ohne einen Schlüssel preiszugeben. Wird ein Schlüssel doch geleakt, änderst du das API-Passwort im Dashboard, und das alte funktioniert nicht mehr.
Sandbox vs. Live und ein kostenloser erster Call
DFS hat eine Sandbox. Gleiche Endpoints, gleiches Anfrageformat, aber ein anderer Hostname, und sie liefert Dummy-Daten, ohne etwas zu berechnen. Nutze sie, während du deinen Parsing-Code schreibst. Du kannst sie so oft aufrufen, wie du willst.
Dann, bevor du Geld für die Live-API ausgibst, mach dort einen Gratis-Aufruf. Der User-Data-Endpoint liefert deine Kontodaten, inklusive deines aktuellen Guthabens. Er kostet nichts.
Wenn dieser Aufruf klappt, funktionieren deine Zugangsdaten. Und ich nutze ihn noch für etwas anderes: Ich prüfe das Guthaben vor jedem großen Lauf, statt einer Zahl zu trauen, die ich letzte Woche notiert habe. Das dauert eine Sekunde und ist kostenlos.
Der erste bezahlte Call: eine Ergebnisseite live
Jetzt der Ernstfall. Wir fragen die Live-Google-Ergebnisseite für ein Keyword ab. Der Endpoint ist organic live advanced, unter SERP, Google.
Der Request-Body ist eine kleine Liste von Tasks. Jeder Task hat ein Keyword, einen Standort, eine Sprache und eine Tiefe, also wie viele Ergebnisse du willst. Standort und Sprache sind sehr wichtig. Dasselbe Keyword liefert in verschiedenen Ländern andere Ergebnisse, also setz sie immer explizit.
Tiefe zehn heißt: die erste Seite. Laut meiner Abrechnung sind das etwa drei Zehntel Cent.
Der Aufruf dauert ein paar Sekunden, weil er live ist: DFS ruft die Seite genau in dem Moment ab. Und hier ist unsere Antwort.
Das JSON lesen
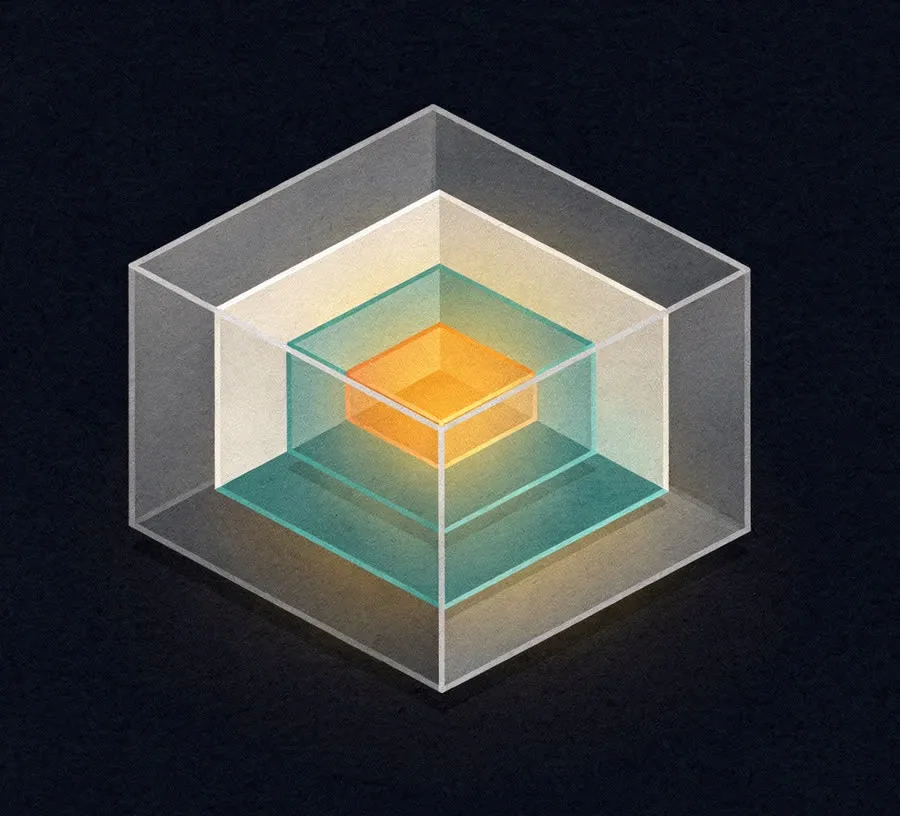
Die Antwort wirkt groß, ist aber nur vier Ebenen tief, und du musst nur diese vier kennen.
Ganz oben ein Statuscode und die Kosten für die ganze Anfrage. Dann eine Liste von Tasks, einer pro gesendetem Task, jeder mit eigenem Statuscode. In jedem Task ein result. Und im result eine Liste namens items. Das ist die Ergebnisseite.
Jedes Item hat einen Typ. „Organic“ ist ein normaler blauer Link. Du siehst aber auch Typen für Featured Snippets, „Ähnliche Fragen“, Local Packs, Videos und so weiter. Jedes Item hat eine Position auf der Seite, eine Domain, eine URL und einen Titel.
Ein Detail, das viele verwirrt: Es gibt zwei Rangnummern. Eine zählt jedes Element auf der Seite, Features inklusive. Die andere zählt nur innerhalb desselben Typs, das erste organische Ergebnis ist also Nummer eins unter den organischen, auch wenn ein Snippet und eine Karte darüber stehen. Entscheide, welche deine Analyse nutzt, und bleib dabei.
Die erste Parsing-Regel ist also einfach: Geh die Items in einer Schleife durch und schau immer zuerst auf den Typ, bevor du etwas anderes liest. Viel tiefer in die Features gehen wir in Folge achtundzwanzig.
Live- vs. Task-Modus und Fehlercodes
Was wir gerade gemacht haben, ist der Live-Modus: eine Anfrage, eine Antwort. DFS hat auch einen Task-Modus. Du sendest die Tasks, sie kommen in eine Warteschlange, du holst sie später ab. Das ist pro Anfrage günstiger und gut für große Batches, wenn du die Antwort nicht sofort brauchst. Zum Lernen und für kleine Checks ist live einfacher.
Fehler. Jede Antwort hat einen Statuscode. Zwanzigtausend heißt OK. Codes im Bereich vierzigtausend heißen, dass mit deiner Anfrage etwas nicht stimmt, etwa ein falscher Parameter oder ein aufgebrauchtes Guthaben. Der Bereich fünfzigtausend heißt: ein Problem auf deren Seite. Prüf den Statuscode jedes Tasks, nicht nur den der ganzen Antwort. Eine Anfrage kann erfolgreich sein, während ein Task darin fehlschlägt.
Die Antwort cachen
Letzter Schritt, und der spart am meisten Geld. Bevor du irgendetwas parst, speichere die Rohantwort auf der Festplatte. Eine Datei pro Keyword, Standort, Sprache, Tiefe und Datum, damit der Dateiname genau sagt, was drin ist.
Dann schreib dein Skript so, dass es zuerst den Cache prüft. Gibt es die Datei, lies sie. Wenn nicht, mach den bezahlten Aufruf und speichere ihn. Jetzt kostet ein Absturz in deinem Parsing-Code nichts, und du kannst deine Analyse so oft wiederholen, wie du willst.
Du bekommst damit auch eine Historie. Ein Ordner gespeicherter Ergebnisseiten ist eine Zeitreihe zum späteren Vergleich.
Vom JSON zur Tabellenzeile
Die gecachte Datei ist die Quelle der Wahrheit. Aber für die Analyse willst du Zeilen, kein verschachteltes JSON.
Der Parser hat also genau eine Aufgabe. Für jedes Item schreibt er eine Zeile: Datum, Keyword, den angefragten Standort und das Gerät, den Rang, Typ, Domain, URL und Titel. Mehr wird in diesem Schritt nicht entschieden. Kein Filtern, kein Scoring.
Diese Tabelle ist der SERP-Teil des Datenmodells, das wir in Folge fünf bauen. Weil du die Rohdatei behalten hast, kannst du später jederzeit eine Spalte ergänzen, etwa ein Feature, das dich heute nicht interessiert, indem du den Cache neu parst. Kein neuer Aufruf, keine neuen Kosten.
Fazit
Zugangsdaten außerhalb des Projekts, zuerst ein Gratis-Check, ein Live-Aufruf, und Cache vor dem Parsen. Das Starter-Skript ist in der Beschreibung verlinkt. Nächste Folge: deine eigenen Daten aus der Search Console API holen. Bis dann.