AI SEO In Detail › Module A · Les fondations › Épisode 3
API DataForSEO de zéro : votre premier appel
Créez un compte DataForSEO, testez en sandbox, passez votre premier appel SERP live payant, lisez le JSON et mettez la réponse en cache. Kit gratuit.
La lecture de la vidéo la charge depuis YouTube (mode privacy-enhanced). La vidéo est en anglais, avec des sous-titres dans votre langue.
Script de démarrage pour le premier appel DataForSEO
Un petit script Python pour démarrer avec DataForSEO : identifiants dans des variables d'environnement, vérification gratuite du solde, une requête de page de résultats en live avec confirmation du coût, codes de statut contrôlés par tâche, et réponse brute mise en cache avant d'être analysée dans SQLite.
- Identifiants hors du projet — Placez votre login API et votre mot de passe API dans un fichier privé de votre dossier personnel et chargez-les comme variables d'environnement. Le script ne les contient jamais.
- Vérification gratuite, puis sandbox — Lancez l'appel gratuit de solde pour vérifier que vos identifiants fonctionnent, puis développez et testez votre analyse dans la sandbox, qui renvoie des données fictives et n'est pas facturée.
- Un appel live, mis en cache — Le script affiche le coût estimé, demande un oui, enregistre le JSON brut avant l'analyse et écrit une ligne par résultat dans SQLite. Les relances lisent le cache gratuitement.
Python 3.9+ · bibliothèque standard uniquement · aucune clé incluse · sans inscription
Les fichiers sont en anglais.
1,023 mots · traduction de la narration de l’épisode.
Introduction
La documentation DataForSEO compte des centaines d'endpoints. Vous l'ouvrez, vous faites défiler, et une heure plus tard, vous n'avez toujours fait aucune requête.
Vous n'avez pas besoin de centaines d'endpoints. Pour commencer, il vous faut trois choses : des identifiants stockés en sécurité, un appel gratuit pour vérifier que tout marche, et un appel payant qui renvoie quelque chose d'utile.
Ici, on passe d'un compte neuf à une page de résultats live en Python, on lit la réponse et on la sauvegarde pour ne jamais la payer deux fois.
Compte et identifiants
D'abord, le compte. Inscription, petit dépôt, et l'API est facturée à l'usage. Pas d'abonnement. Chaque appel est débité de votre solde.
Dans le tableau de bord, vous trouvez votre login API et un mot de passe API. Attention : ce n'est pas le mot de passe de connexion au site. L'API utilise l'authentification basique : login et mot de passe API à chaque requête.
Maintenant, l'habitude la plus importante de cet épisode. Ces identifiants ne vont jamais dans votre script. Ni dans le code, ni dans un notebook, ni dans un chat avec une IA.
Je les garde dans un petit fichier d'environnement dans mon dossier personnel, hors de tout projet, lisible par mon seul utilisateur. Le script lit deux variables d'environnement à l'exécution. Ainsi, le dossier du projet peut être partagé, synchronisé ou versionné sans divulguer de clé. Si une clé fuit, changez le mot de passe API dans le tableau de bord, et l'ancien cesse de fonctionner.
Sandbox ou live, et un premier appel gratuit
DFS a un sandbox. Mêmes endpoints, même format de requête, mais un autre hostname, et il renvoie des données factices sans rien facturer. Utilisez-le pendant que vous écrivez votre parsing. Vous pouvez le solliciter autant que vous voulez.
Puis, avant de dépenser sur l'API live, faites-y un appel gratuit. L'endpoint user data renvoie les infos de votre compte, dont votre solde actuel. C'est gratuit.
Si cet appel marche, vos identifiants marchent. Et je m'en sers aussi pour autre chose : je vérifie le solde avant chaque gros traitement, au lieu de me fier à un chiffre noté la semaine dernière. Ça prend une seconde et c'est gratuit.
Le premier appel payant : une page de résultats en live
Passons au concret. On demande la page Google live pour un mot-clé. L'endpoint est organic live advanced, sous SERP, Google.
Le corps de la requête est une petite liste de tâches. Chaque tâche a un mot-clé, un lieu, une langue et une profondeur, soit le nombre de résultats voulus. Le lieu et la langue comptent beaucoup. Le même mot-clé donne des résultats différents selon le pays, donc définissez-les toujours explicitement.
Profondeur dix, c'est la première page. Sur ma facture, ça fait environ trois dixièmes de cent.
L'appel prend quelques secondes, car il est live : DFS récupère la page à ce moment-là. Et voici notre réponse.
Lire le JSON
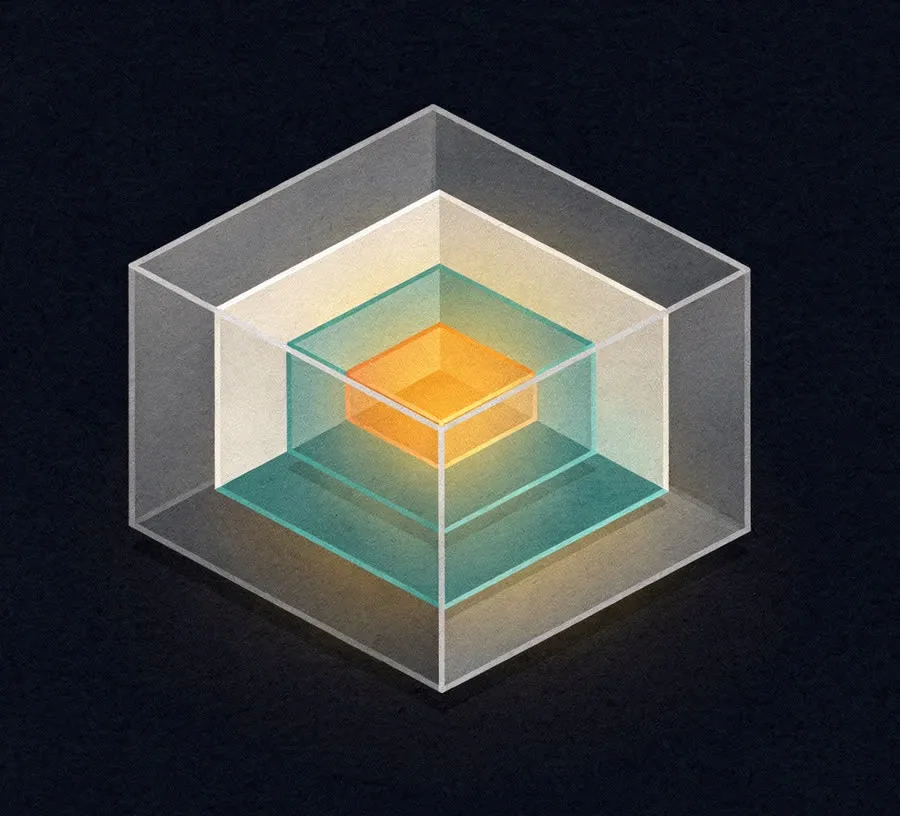
La réponse paraît énorme, mais elle a quatre niveaux, et vous n'avez besoin de connaître que ces quatre.
En haut, un code de statut et un coût pour toute la requête. Puis une liste de tâches, une par tâche envoyée, chacune avec son code de statut. Dans chaque tâche, un result. Et dans le result, une liste appelée items. C'est la page de résultats.
Chaque item a un type. « Organic » est un lien bleu classique. Mais vous verrez aussi des extraits optimisés, « Autres questions », local packs, des vidéos, etc. Chaque item a une position, un domaine, une URL et un titre.
Un détail qui trouble souvent : il y a deux numéros de rang. L'un compte chaque élément de la page, features comprises. L'autre compte seulement au sein du même type, donc le premier résultat organique est numéro un parmi les organiques, même si un extrait et une carte sont au-dessus. Choisissez lequel votre analyse utilise, et tenez-vous-y.
La première règle de parsing est donc simple : parcourez les items en boucle, et regardez toujours le type avant de lire autre chose. On ira bien plus loin sur les features à l'épisode vingt-huit.
Mode live ou mode task, et codes d'erreur
Ce qu'on vient de faire, c'est le mode live : une requête, une réponse. DFS a aussi un mode task. Vous envoyez les tâches, elles sont en file, et vous récupérez plus tard. C'est moins cher par requête et adapté aux gros lots quand la réponse n'est pas urgente. Pour apprendre et pour de petits tests, le live est plus simple.
Les erreurs. Chaque réponse a un code de statut. Vingt mille signifie OK. Les codes autour de quarante mille signalent un problème dans votre requête, comme un mauvais paramètre ou un solde épuisé. Autour de cinquante mille, le problème vient de chez eux. Vérifiez le code de chaque tâche, pas seulement celui de la réponse. Une requête peut réussir alors qu'une de ses tâches échoue.
Mettre la réponse en cache
Dernière étape, et c'est elle qui économise le plus. Avant tout parsing, sauvegardez la réponse brute sur disque. Un fichier par mot-clé, lieu, langue, profondeur et date, pour que le nom du fichier dise exactement ce qu'il contient.
Puis faites vérifier le cache d'abord par votre script. Si le fichier existe, lisez-le. Sinon, faites l'appel payant et sauvegardez-le. Désormais, un plantage du parsing ne coûte rien, et vous pouvez relancer l'analyse autant de fois que vous voulez.
Ça vous donne aussi un historique. Un dossier de pages sauvegardées est une série temporelle à comparer plus tard.
Du JSON à une ligne de tableau
Le fichier en cache fait foi. Mais pour l'analyse, il vous faut des lignes, pas du JSON imbriqué.
Le parser ne fait donc qu'une chose. Pour chaque item, il écrit une ligne : la date, le mot-clé, le lieu et l'appareil demandés, le rang, le type, le domaine, l'URL et le titre. Rien d'autre n'est décidé à ce stade. Pas de filtre, pas de score.
Cette table est la partie SERP du modèle de données de l'épisode cinq. Comme vous avez gardé le fichier brut, vous pourrez ajouter une colonne, comme une feature ignorée aujourd'hui, en reparsant le cache. Pas de nouvel appel, pas de nouveau coût.
Pour conclure
Identifiants hors du projet, un test gratuit d'abord, un appel live, et le cache avant le parsing. Le script de départ est en description. Prochain épisode : récupérer vos données via l'API Search Console. À bientôt.